
Claude Sonnet 5.5は入力2ドルで使える主力モデル
Claude Sonnet 5.5は、2026年9月28日に公開されたAnthropicのモデルです。APIではclaude-sonnet-5-5を指定し、1Mトークンのコンテキストと最大128Kトークンの出力に対応します。
料金は入力100万トークンあたり2ドル、出力10ドルで、Sonnet 5と同じです。Anthropicは、前世代より1タスクあたり最大30%少ない費用で動くと説明しています。個人開発では、まずSonnet 5.5を標準にして、足りない場面だけ上位モデルへ上げる使い方が現実的です。
※ 用語:コンテキスト=モデルが1回で参照できる入力や会話履歴の範囲。トークン=AIが文章を処理・課金するときの単位です。
Claude Sonnet 5.5の性能はSonnet 5から大きく伸びた
公式発表では、Terminal-Bench 4.0でSonnet 5.5が70.6%、Sonnet 5が10.3%、Opus 5.5が66.4%でした。CursorBench 4.0は55.5%(Sonnet 5は34.1%)、OSWorld 2.1は80.1%(同57.0%)です。
| 評価 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 10.3% | 66.4% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% |
| OSWorld 2.1(一部) | 80.1% | 57.0% | 81.8% |
| Humanity's Last Exam(ツールあり) | 64.5% | 54.9% | 67.7% |
出力は、Sonnet 5より30%以上速いとされています。一方で、FrontierCode 1.1は52.1%でOpus 5.5の54.4%を下回るなど、すべてで上位モデルを超えるわけではありません。
※ 用語:ベンチマーク=決められた課題と採点方法でモデル性能を比べる試験。OSWorld=画面操作の能力を測る評価です。
努力レベルで正答率と費用が変わる
公式ページのTerminal-Bench 4.0では、努力レベル(effort)ごとの正答率と1タスク平均費用が示されています。Sonnet 5.5はLowで20.0%・0.76ドル、Maxで70.6%・12.54ドルです。
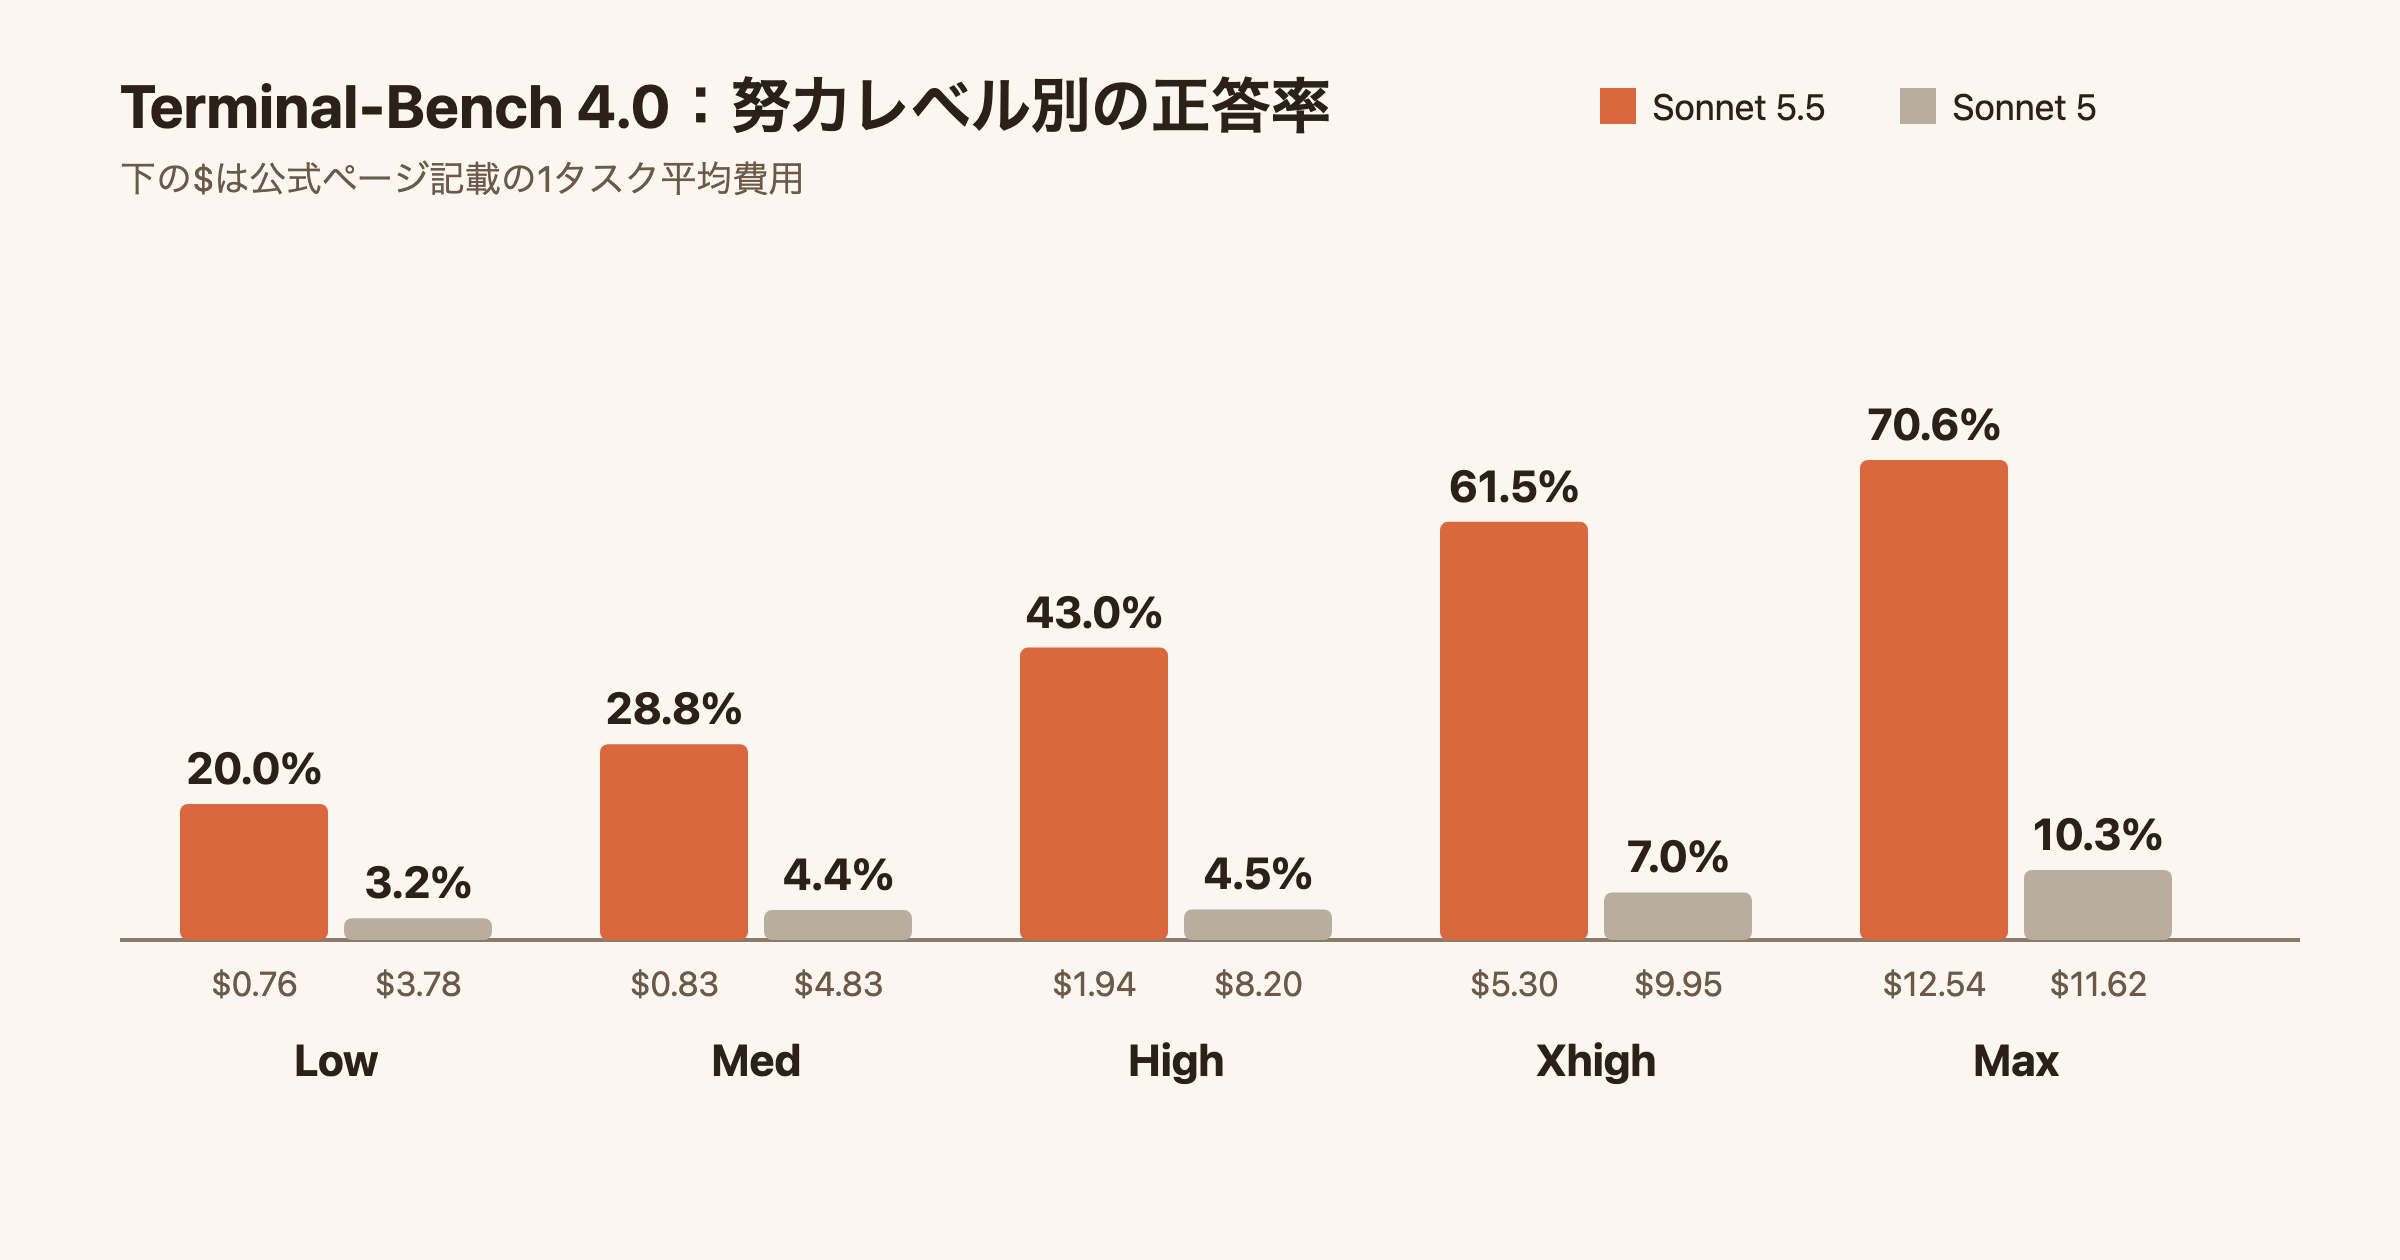
同じLowでもSonnet 5は3.2%・3.78ドルでした。低い努力レベルで試し、失敗するタスクだけ上げる運用なら、費用を抑えながら精度を確保できます。なお公式のグラフは画像ではなく動的な表示のため、上の図は公表値から作り直しています。
※ 用語:努力レベル=回答前の推論にかける計算量を調整する設定。Xhighはその上位の段階です。
個人開発での使いどころと料金の目安
- 既存コードの修正や、テストを回しながらの自動実装(Claude Codeなどのエージェント)
- 画面操作を伴う自動化やグラフ画像の読み取り
- 仕様書やREADMEなど、読みやすさが要る文章の下書き
バッチ処理なら入力1ドル・出力5ドルで、キャッシュ読み出しは0.20ドルです。共通の設計資料を繰り返し渡す処理ほど、キャッシュが効きます。
Claude APIのほか、Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWSでも使えます。関連して、AI活用の進め方はAI駆動開発でポートフォリオサイトを作った話にもまとめています。
※ 用語:バッチ処理=すぐに結果が要らない大量の依頼をまとめて送り、料金を下げる方式。キャッシュ=同じ入力の再処理を避ける仕組みです。
Sonnet 5からの移行で壊れやすい点
移行ガイドによると、thinkingを指定しない場合もAdaptive Thinking(推論量の自動調整)が動きます。Sonnet 5で使えたthinking: {"type": "disabled"}は400エラーになり、最も低い設定はbetween_toolsです。
temperature・top_p・top_kを既定値以外にすると400エラー- ツールの強制指定(forced tool use)はエラー
- 応答が
thinkingブロックで始まるため、content[0].textと読む実装は壊れる max_tokensは思考分を含み、思考トークンも出力として課金される
※ 用語:thinkingブロック=モデルの推論を保持するAPI上のデータ。400エラー=リクエストの内容が不正なときに返るエラーです。
個人的な見解と個人開発での安全な使い方
個人向けの見解
Opus 5.5の半額でここまで近い結果が出るなら、個人開発の標準はSonnet 5.5で十分だと考えています。ただしベンチマークは公式の条件での値なので、自分のリポジトリで成功率と費用を数回試してから決めるのが安全だと感じています。
個人開発での安全確認
- 秘密鍵、
.env、個人情報をプロンプトへ含めない - 月額とタスクごとのトークン上限を先に決める
- 削除・公開・課金処理は、人が差分を確認してから実行する
- 移行時は
thinking関連の設定とレスポンスの読み取りを回帰テストする
※ 用語:上限設定=使いすぎを防ぐため、月額やタスク単位で決めておく利用量の制限です。
まとめ
- Sonnet 5.5は1Mコンテキスト・128K出力で、入力2ドル・出力10ドル
- Terminal-Bench 4.0は70.6%でSonnet 5の10.3%から大きく向上
- 低い努力レベルから試し、必要な時だけ上げると費用を抑えやすい
- Sonnet 5からの移行は
thinkingとtemperature系の設定に注意
※ 用語:回帰テスト=変更後も以前の機能が壊れていないか確かめる試験です。